Pirmuosius TPU Google sukūrė daugiau nei prieš dešimtmetį, kai jų prireikė vidiniams bendrovės poreikiams, tarp jų balso atpažinimui ir kalbų vertimui. Praėjus aštuonioms TPU kartoms, panaudojimo atvejų smarkiai padaugėjo: i) TPU naudojami savo Gemini modeliams apmokyti ir aptarnauti, ii) agentinėms (angl. agentic) darbo apkrovoms, iii) paslaugoms „Google Cloud“ klientams teikti bendrovės debesijos infrastruktūroje, o visai neseniai ir iv) klientams leidžiama TPU diegti tiesiai savo duomenų centruose. Šiandien TPU yra sparčiai augantis verslas, turintis beveik 100 klientų, tarp jų pažangiausių modelių laboratorijų, prekybos įmonių, mažmenininkų, universitetų ir kitų organizacijų.
Paaiškinimas: TPU (angl. Tensor Processing Unit) yra Google sukurti specializuoti procesoriai, skirti dirbtinio intelekto modelių skaičiavimams pagreitinti.
Balandį vykusioje konferencijoje „Google Cloud Next“ bendrovė pristatė du naujus specializuotus tos pačios kartos TPU: 8t, skirtą didelio masto mokymui, ir 8i, skirtą realaus laiko samprotavimui. Pasak Google, TPU 8t ir 8i, palyginti su ankstesne TPU karta, siūlo iki 2,7 karto geresnį mokymo našumą ir 80 % geresnį išvadų darymo (angl. inference) kainos ir našumo santykį.
Šiandien Google žengia dar vieną žingsnį ir plečia aštuntosios kartos TPU portfelį dviem papildomomis sistemomis: TPU 8i Max, skirta milžiniškiems konteksto langams ir didžiausiam skaičiavimo tankiui vienoje spintoje (angl. rack), bei TPU 8tx, skirta saugioms ir konfidencialioms išvadoms. Bendrovė pirmą kartą per vienus metus pristatė net keturias TPU sistemas.
Išplėstas aštuntosios kartos TPU portfelis: TPU 8t, TPU 8i, TPU 8tx ir TPU 8i Max.
Nors TPU visada buvo kuriami kartu su „Google DeepMind“, dabar Google vis dažniau sulaukia atsiliepimų ir iš išorinių organizacijų apie jų konkrečius poreikius. Skaičiavimams pereinant nuo žmogaus prie agentų mastelio, įmonės prašo greitintuvų, galinčių samprotauti per milžiniškus dirbtinio intelekto modelių konteksto langus. Be to, kai kurie griežtai reguliuojamų sektorių klientai prašo specializuotų šifravimo galimybių ypatingoms darbo apkrovoms.
Paaiškinimas: Konteksto langas yra informacijos kiekis, kurį dirbtinio intelekto modelis gali aprėpti ir apdoroti vienu metu, pavyzdžiui, ilgas tekstas ar visas programinio kodo rinkinys.
Šiandien paskelbtos naujos TPU sistemos skirtos šiai naujai tikrovei. Kartu su neseniai paskelbtomis PyTorch naujovėmis Google siekia, kad TPU taptų lengviau prieinami kiekvienam kūrėjui ir „Cloud“ klientui. Bendrovės teigimu, derindama modulinį specializuotą silicį su atvira ir lengvai naudojama programine įranga, ji gali pateikti naują aparatinę įrangą ir sistemų konfigūracijas dirbtinio intelekto pramonės tempu.
Kompiuterio kūrimas aplink lustą
Šiandien Google skelbia dvi naujas TPU sistemas, o tarp naujo lusto ir naujos sistemos esama svarbaus skirtumo.
Naujo lusto kūrimas reiškia milijardų mikroskopinių tranzistorių išdėstymą silicio plokštelėje: tai kelerius metus trunkantis procesas, ribojamas fizikos dėsnių ir sudėtingo, ilgo gamybos ciklo. Sistema, priešingai, yra apie tai, kaip aplink lustą sujungiami skaičiavimo, tinklo ir saugyklos ištekliai. Tai gali apimti ir tai, kaip jie supakuojami kartu su lustais, kad būtų greitai patenkinti kylantys klientų poreikiai ir tyrimų atvejai.
Kai daugiau nei prieš dešimtmetį buvo kuriamas pats pirmasis TPU, Google suprato, kad dirbtinio intelekto programinė įranga vystysis gerokai greičiau nei kada nors galės keistis silicio gamyba. Todėl bendrovė pasirinko pagrindinį principą – sistemos pusiausvyrą ir modulinę sandarą: TPU buvo projektuojami kaip statybiniai blokai, įeinantys į „AI Hypercomputer“ platformą, kad inžinieriai galėtų greitai keisti jų pakuotę, sparčiąją atmintį, optinį tinklą ir saugumo sprendimus. Pasak bendrovės, tokia prieiga leidžia specializuotus superkompiuterius pateikti per mėnesius, o ne per metus.
Specializacija saugiam dirbtiniam intelektui su dideliu kontekstu
Kiekviena aštuntosios kartos TPU portfelio sistema skirta atskirai dirbtinio intelekto gyvavimo ciklo daliai.
TPU 8t ir TPU 8i nustatė šios lustų kartos pagrindą:
- TPU 8t sukurtas kaip mokymo galiūnas milžiniškiems pagrindiniams (angl. foundation) modeliams, užtikrinantis didžiausią „goodput“ – naudingo intelekto kiekį, tenkantį sunaudotam energijos vatui.
- TPU 8i yra samprotavimo variklis, skirtas pralaužti atminties sieną (angl. memory wall) ir iki pusės sutrumpinti vėlinimus tarp lustų.
Įmonėms diegiant autonominius agentus į gamybą, Google sukūrė dvi naujas šių pagrindinių sistemų konfigūracijas, skirtas dviem skubiems naujiems iššūkiams spręsti: duomenų saugumui aparatinės įrangos lygiu ir milijono žetonų (angl. token) konteksto mastui.
TPU 8tx
TPU 8tx, trečioji aštuntosios kartos sistema, optimizuota saugioms ir konfidencialioms išvadoms, taip pat tinka nedidelio masto mokymui. Ji sukurta reguliuojamoms įmonėms ir vyriausybėms, kurios kartu su jautriausiais duomenimis naudoja pažangiausius ar nuosavus modelius ir autonominius agentus.
Paprastai duomenys šifruojami saugant arba siunčiant tinklu, tačiau kompiuteriui juos apdorojant atmintyje jie turi būti atrakinti. TPU 8tx, sukurtas ant to paties silicio kaip TPU 8t ir suporuotas su 5-osios kartos AMD EPYC procesorių šeimininkais (angl. hosts), saugumą įtraukia tiesiai į aparatinės įrangos sluoksnį, todėl jautrūs duomenys ir modelių svoriai išlieka apsaugoti ir izoliuoti net aktyviai naudojami. Be to, pritaikius tą patį mažo vėlinimo „Boardfly“ tinklą, sukurtą realaus laiko samprotavimui, TPU 8tx užtikrina sklandų daugiapakopių agentų darbą: vėlinimas iki 2 kartų mažesnis nei TPU 8t, o našumas sumažėja beveik nepastebimai.
Mokymo klasės skaičiavimų ir greito išvadų tinklo derinys taip pat reiškia, kad organizacijos gali tuo pačiu metu vykdyti ir pritaikyti savo modelius vienoje sistemoje. TPU 8tx leidžia komandoms tiksliai derinti (angl. fine-tune) modelius naudojant privačius duomenis, distiliuoti didelius modelius į mažesnius ir mokyti savo agentus skatinamuoju mokymu (angl. reinforcement learning) – visa tai nereikalaujant perkelti jautrių duomenų tarp atskirų klasterių.
TPU 8tx, skirta jautrioms įmonių darbo apkrovoms, suteikia aparatinės įrangos lygio konfidencialius skaičiavimus privačiam tiksliam derinimui ir saugiam agentų vykdymui.
TPU 8i Max
Ketvirtoji sistema, TPU 8i Max, sukurta kitai problemai spręsti – atminties sienai.
Kai dešimtys dirbtinio intelekto agentų kartu dirba su visu programinio kodo rinkiniu ar kelių valandų vaizdo įrašais vienu metu, atminties pralaidumas greitai tampa kliūtimi. Todėl Google sujungė du mažo vėlinimo TPU 8i lustus į vieną korpusą.
TPU 8i Max proporcingai didina skaičiavimo galią ir atmintį: lyginant su TPU 8i, jis turi dvigubai daugiau skaičiavimo resursų, dvigubai daugiau SRAM ir dvigubai didesnį HBM pralaidumą, todėl procesoriai nuolat aprūpinami reikiamais duomenimis, o didelės darbo apkrovos nestringa. Be to, kadangi TPU 8i Max toje pačioje spintoje telpa dvigubai daugiau silicio, duomenų centrai gali įdiegti gerokai daugiau skaičiavimo galios kvadratiniam pėdos plotui ir vatui.
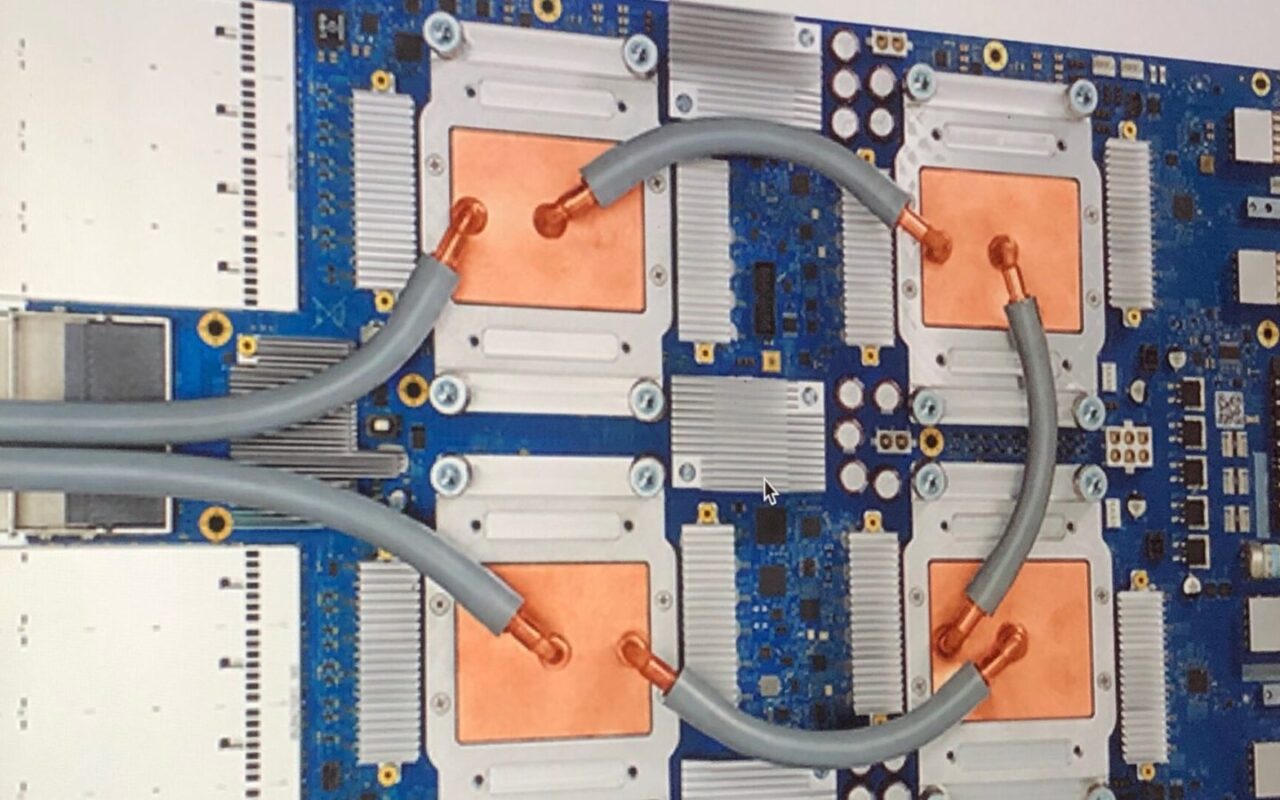
Dviejų lustų TPU 8i Max sistema, sukurta milžiniškiems konteksto langams ir didžiausiam skaičiavimo tankiui.
Nors visos keturios aštuntosios kartos TPU sistemos yra lanksčios skirtingoms darbo apkrovoms, kartu jos klientams suteikia specialiai sukurtą greitintuvą kiekvienam agentinio gyvavimo ciklo etapui: TPU 8t – didelio masto mokymui, TPU 8i – mažo vėlinimo samprotavimui, TPU 8tx – konfidencialiems skaičiavimams, o TPU 8i Max – milžiniškiems konteksto langams ir didžiausiam skaičiavimo tankiui spintoje.
TPU atvėrimas kiekvienam kūrėjui
Kai daugiau nei prieš dešimtmetį buvo pristatytas pirmasis TPU, tik saujelė įmonių vykdė darbo apkrovas, kurioms reikėjo TPU apdorojimo galios. Panaudojimo atvejai buvo specializuoti, todėl inžinieriai naudojo optimizuotas sistemas (angl. frameworks) ir ranka derintą kodą.
Dirbtiniam intelektui tobulėjant, vis daugiau įmonių ėmė naudoti greitintuvus. Šiandien dirbtinio intelekto diegimas pasiekė tašką, kai TPU puikiai tinka plačiam įmonių ir panaudojimo atvejų ratui, todėl Google sistemingai šalina diegimo kliūtis, kad TPU būtų tokie pat paprasti naudoti kaip bendrosios paskirties aparatinė įranga.
Šios investicijos šiandien pasireiškia šiose pagrindinėse srityse:
- TPU kūrimas atveriamas kiekvienam PyTorch kūrėjui, be kodo perrašymo: Praėjusį mėnesį Google atvėrė TorchTPU šaltinio kodą, todėl PyTorch kodas ir „Hugging Face“ modeliai dabar veikia TPU natūraliai, o pagrindiniams atvirojo kodo išvadų varikliams, tokiems kaip vLLM ir SGLang, yra paruošti TPU backend’ai. Kad aparatinės įrangos optimizavimas būtų paprastas, naujas atvirojo kodo TPU agentų rinkinys (dabar peržiūros versija) jungiasi tiesiai prie programavimo įrankių, tokių kaip Claude Code, Cursor ir Google Antigravity, ir leidžia per kelias minutes automatizuoti darbo su TPU pradžią, diagnozuoti kliūtis bei automatiškai derinti pritaikytus branduolius (angl. kernels) paprasta kalba. Gamybiniam diegimui skirtas naujas atvirojo kodo „XLA Serving Engine“ leidžia modelius mokyti Python kalba ir aptarnauti tiesiogiai mažo vėlinimo C++ vykdymo aplinkoje TPU, GPU ir CPU.
- Pirmaujantis gamybinis našumas InferenceX ir AgentX testuose:
Gamyboje svarbiausi yra rezultatai su tikromis dirbtinio intelekto darbo apkrovomis, o ne teoriniai didžiausi lusto greičiai. Pramonės standarto InferenceX ir AgentX testuose, kuriuose tikrinamas realistiškas agentinis programavimas ir darbas su ilgu kontekstu, Google natūrali vLLM-TorchTPU programinė sistema TPU pasiekė pažangiausius kainos ir našumo rodiklius. Naujos vertinimo ataskaitos rodo, kad šie privalumai galioja plačiam pažangiausių atvirų modelių ir atvirojo kodo aptarnavimo sistemų spektrui, o modelių tikslumas išlieka aukštas. Bendrovės teigimu, būsimos programinės įrangos optimizacijos toje pačioje aparatinėje įrangoje šiuos rezultatus pagerins dar labiau. - Tuščios skaičiavimo galios švaistymo autonominiams agentams pašalinimas: Kadangi dirbtinio intelekto agentai išlaiko būseną (angl. stateful), jie dažnai sustoja sekundėms ar valandoms, laukdami duomenų bazės užklausos, išorinio programinio įrankio ar žmogaus atsiliepimo. Kad greitintuvai tomis pauzėmis naudotų mažiau energijos, nauja „Agent Compute Engine“ programinė įranga automatiškai sustabdo neveikiančias agentų sesijas ir per milisekundes perkelia darbinę atmintį iš lusto, taip mažindama infrastruktūros eksploatavimo išlaidas.
- Atminties sienos pralaužimas modelio būsenos sluoksniu (TPU Sync): Kompiuterio kūrimas aplink lustą taip pat reiškia atminties, saugyklos ir tinklo suvienijimą programinės įrangos lygiu. Agentams samprotaujant milijono žetonų kontekstuose ir nuolatiniuose skatinamojo mokymo (RL) ciklouose, atmintis greitai tampa kliūtimi. Google atveria TPU Sync – TPU klasterių modelio būsenos sluoksnio – šaltinio kodą. TPU Sync lusto HBM, šeimininko DRAM, bendrąją saugyklą ir duomenų centro tinklą paverčia viena kartu suprojektuota atminties hierarchija: automatiškai per milisekundes perkelia didžiules KV talpyklas iš lusto į kitus lygius, perduoda kontekstą tarp išskaidytų pradinio apdorojimo (angl. prefill) ir dekodavimo mazgų bei sinchronizuoja RL svorius, taip daugiau nei 90 % sumažindamas KV perdavimo vėlinimą ir laiką iki pirmojo žetono (angl. Time to First Token, TTFT).
- Paskirstytų darbo apkrovų mastelio keitimas per TPU iš vieno valdiklio: „Cloud Pathways“, dabar bendrai prieinamas „Google Kubernetes Engine“ (GKE) platformoje, kiekvienam „Google Cloud“ klientui suteikia „Google DeepMind“ vykdymo aplinką, kuria remiasi Gemini. Naudojant vieno valdiklio architektūrą ir pathwaysutils, didelio masto TPU sistemas per kelias atkarpas (angl. slices) galima valdyti taip, tarsi tai būtų viena vietinė mašina, išankstiniam mokymui, skatinamajam mokymui ir daugiaserveriam išvadų darymui. „Cloud Pathways“ padeda ilgai trunkančioms užduotims tęstis ir sutrikus aparatinei įrangai: tam naudojami kartu išdėstyti Python šoniniai konteineriai (angl. sidecars), mažiau nei per minutę atliekamas atkarpų karštasis keitimas ir elastinis pergrupavimas (angl. resharding).
- Pritaikytų TPU topologijų sudarymas pagal poreikį su GKE dinaminiu skaidymu: GKE dinaminis skaidymas (angl. dynamic slicing), dabar bendrai prieinamas, naudodamas optinio grandinių komutavimo (OCS) technologiją, atskiria fizinės aparatinės įrangos paskirstymą nuo loginių atkarpų formavimo. Dinamiškai sujungiant TPU kubus į didesnes topologijas (angl. super-slicing) arba skaidant juos į mažesnes izoliuotas darbo apkrovas (angl. sub-slicing), šis atnaujinimas visiškai pašalina griežtus, rankinius mazgų telkinių (angl. nodepool) atkūrimo ciklus. Pasak Google, dėl tokio topologijų lankstumo užduočių paleidimo laikas sutrumpėja iki 5 kartų, o atsigavimas po gedimų pagreitėja iki 4,5 karto, todėl maksimaliai išnaudojamas visas parkas ir darbo apkrovų „goodput“ visuose TPU.
Bendras projektavimas, paremtas dešimtmečio patirtimi
Keturias TPU sistemas ir vieningą atvirą programinės įrangos paketą per vienus metus pateikti pavyksta tik tada, kai silicio architektai, tinklų inžinieriai, kompiliatorių komandos ir „Google DeepMind“ tyrėjai dirba petys į petį.
Google vis dažniau pasitelkia dirbtinį intelektą ir kitos kartos dirbtinio intelekto infrastruktūros idėjoms kurti bei jai statyti. Nuo „Google DeepMind“ AlphaChip skatinamojo mokymo sistemos iki Gemini, kuris lustų išdėstymus pateikia per valandas, o ne savaites, bendrovė naudoja TPU varomas dirbtinio intelekto paslaugas, kad sparčiai pagreitintų kitos kartos TPU aparatinės įrangos kūrimą. Google teigimu, tai tikras bendras projektavimas (angl. co-design) ir unikalus bendrovės išskirtinumas.
Daugiau apie naująsias TPU sistemas galima sužinoti žiūrint šiandienos transliaciją 9 val. Ramiojo vandenyno laiku (PT).